Një kompani e vogël, e quajtur TradeMAV, mendon se zgjidhja për të ekzeksuar modele të mëdha AI në shtëpi nuk është blerja e më shumë RAM-it, por shfrytëzimi i memorie që tashmë ekziston në dispozicionin e pajisjeve të tjera.
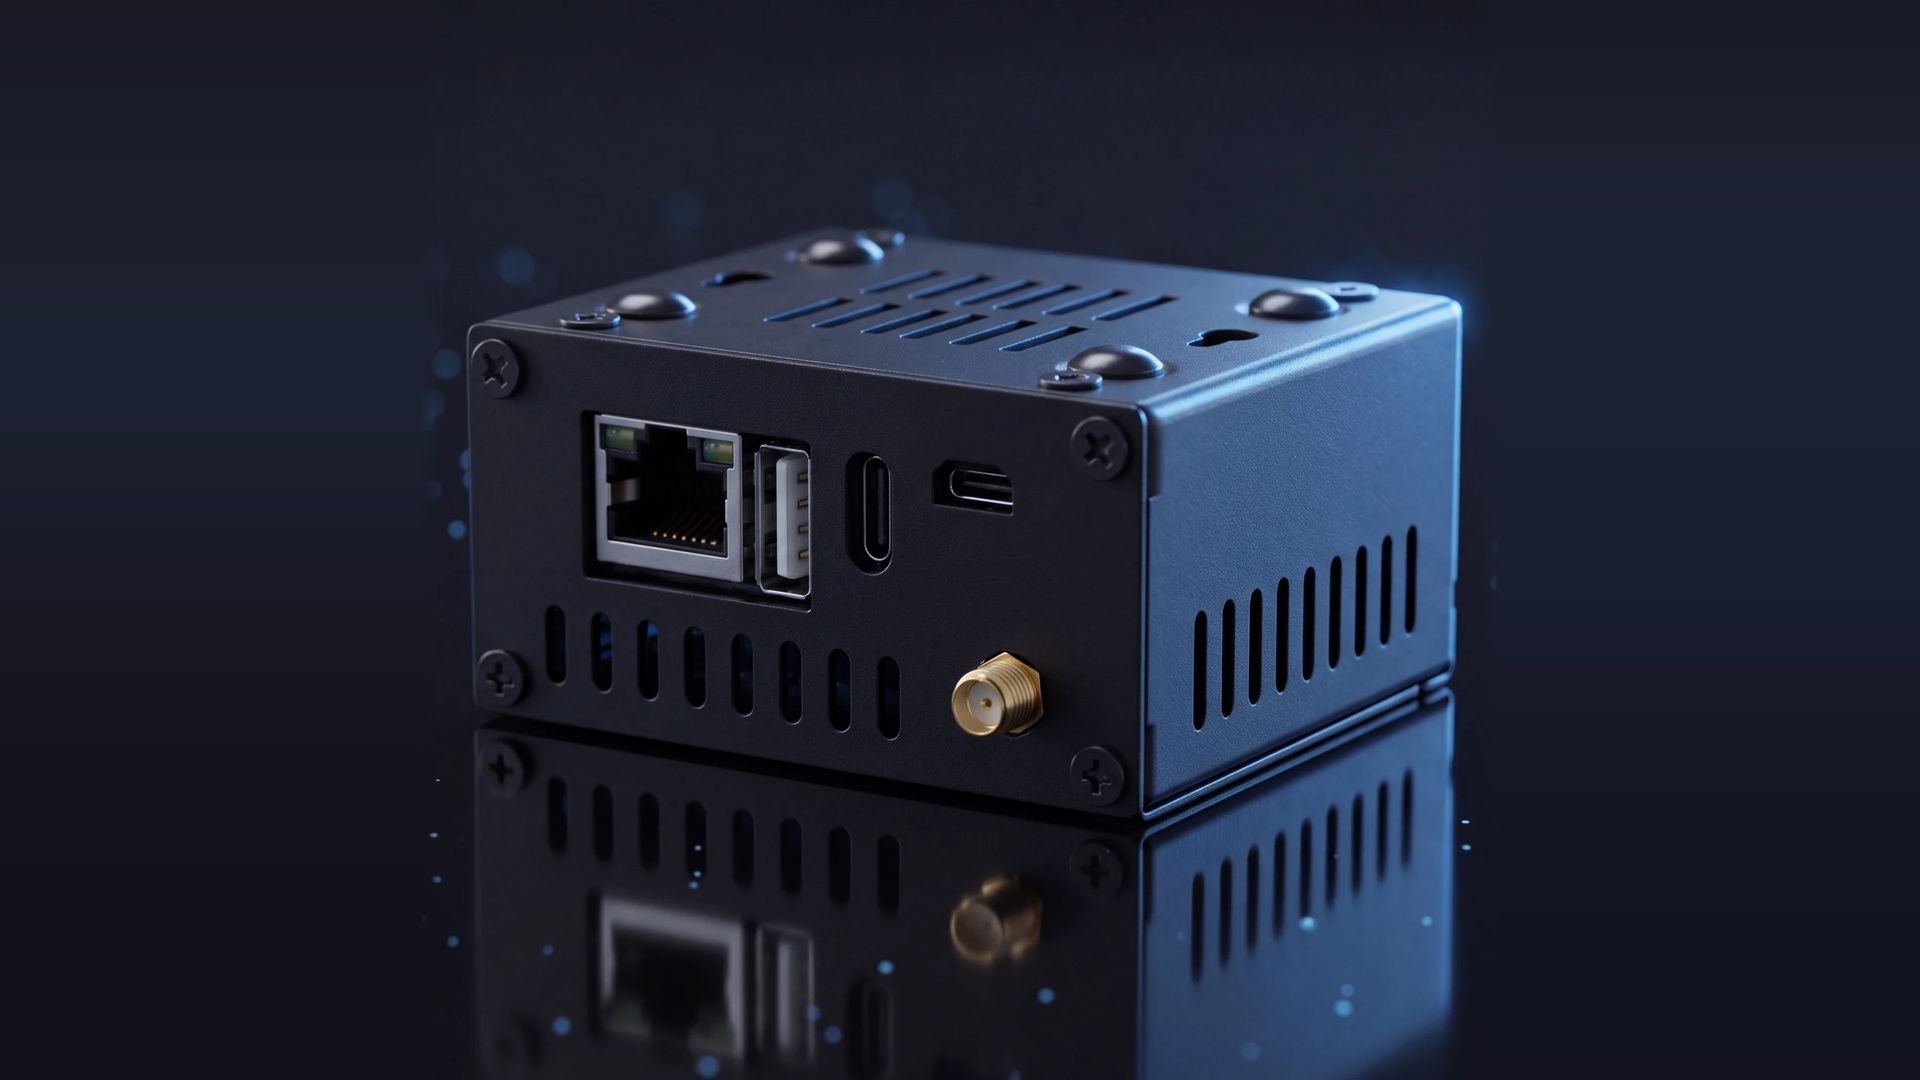
Kjo ide, e cila është e vështirë për t’u kundërshtuar, prezantohet me “RAMDeck”, një hub i vogël dhe me konsum të ulët energjie që lidh kompjuterë Windows, Mac, sisteme Linux dhe telefonë Android në një rrjet shtëpiak, duke i bashkuar në një bazë memorie të vetme, kështu që një model që është shumë i madh për një pajisje të vetme mund të shpërndahet në të gjitha.
Kampanja përdor financim me përkushtim, me një qëllim prej 10,000 dollarësh dhe përfundon më 8 nëntor 2026, sipas videos së prezantimit të kompanisë, ndërsa një tabelë krahasimi e kostove në udhëzimet e TradeMAV për bashkimin e memorieje liston hub-in me 109 dollarë si një ofertë speciale për ata që kontribuojnë herët.
Koha është interesante, për të puthën: të dhënat e shitjes me pakicë nga Gjermania, të mbledhura nga 3DCenter, tregojnë se çmimet e DDR5 janë 486% më të larta se në korrik 2025, deri në mes të gushtit; Samsung ka paralajmëruar analistët se mungesa do të vazgdojë deri në vitin 2028; dhe kryetari i grupit SK ka paralajmëruar se ajo mund të zgjatë deri në vitin 2030.
T gjitha këto faktorë krijojnë një situatë komplekse, dhe TradeMAV e pranon këtë; historia e saj rrënjërohet në të njëjtën presion, duke pohuar se një kit 64GB DDR5 shkoi nga rreth 191 dollarë në gusht 2025 në 1,118 dollarë një vit më vonë. Kjo përputhet përafërsisht me zbulimet tona se çmimet mesatare të një kompleti 2x32GB DDR5-5600 rritën katërfish, duke arritur rreth 800 dollarë, vetëm në trembujëshin e fundit të vitit 2025.
Ajo që RAMDeck bën në fakt është më pak e “ekzotike” sesa sugjeron “bashkimi i memorie”. Asgjë nuk bashkohet në nivelin e harduerit. Përkundrazi, shtresat e modelit ndahen ndërmjet pajisjeve, secila duke mbajtur pjesën e saj në memorie lokale, dhe vetëm rezultatet ndërmjetësoje kalojnë përmes rrjetit ndërsa çdo token gjenerohet.
Depozitumi publik i TradeMAV në GitHub është i hapur rreth detajeve teknike: agjenti i node-it fillon serverin ggml RPC të llama.cpp në çdo pajisje që kontribuon; README thotë se çdo koordinues i përshtatshëm mund ta drejtojë përmes protokolit standard llama.cpp RPC, dhe mënyra e sugjeruar për të verifikuar se funksionon është një komandë standard llama-cli.
Kontributi i TradeMAV është orkestrimi që rrethor: zbulimi automatik, vendosja e shtresave që plotëson harduerin e GPU-ve të shpejtë para se të përdoret RAM-i i sistemit më i ngadalshëm, rikuperimi nga defektet, një dashboard dhe një API e kompatibile me OpenAI, sipas faqes së veçorive.
Ndërsa procesi është i detajuar, komponentët e tjerë të hub-it janë të mangët; asnjë nga faqet e publikuara të TradeMAV nuk liston procesorin, memorie, portet ose konsumin e energjisë. Udhëzimet e veta për bashkimin e memorieje pranojnë se, nëse jeni të rehatshëm me skriptat e terminalit, “rruga ideale është rruga falas dhe me burim të hapur DIY”.
Bashkimi i pajisjeve për inferencë nuk është i ri. Exo Labs’ exo, me burim të hapur, ofron zbulim automatik të pajisjeve dhe një API që mund të integrohet lehtësisht në kompjuterë, telefonë dhe kompjuterë me një kartë, që nga fillimi i vitit 2025. Në segmentin e lartë, Mac Studio i ri M5 Ultra i Apple mbështet grupin përmes Thunderbolt 5 me RDMA, dhe Apple pretendon se katër pajisje ofrojnë deri në tre herë më shumë shpejtësi inferencimi sesa një.
Përpërkimi dallues i RAMDeck është gjerësia – FAQ-ja e tij premton një desktop Windows CUDA, një Mac me procesor Apple Silicon, një Mac me procesor Intel, një sistem Linux dhe një telefon Android në të njëjtën grup, diçka që bëhet e mundur falë kombinimit të backend-eve të llama.cpp.
TradeMAV është e drejtë rreth kompromisit të performancës krahasuar me diçka si një konfigurim Mac Studio. Faqja e historisë së saj paralajmëron se “memoria e bashkuar këmbëngul shpejtësinë për kapacitet”, dhe shkrimi i saj për testimin tregon lexuesve që kërkojnë performancë të lartë të blejnë një GPU me VRAM më të lartë.
Rezultatet kryesore bazohen në një mini PC Beelink me RTX 3060 dhe modele “mixture-of-experts” që aktivizojnë vetëm rreth 3 miliardë parametra për token: 39 tokenë në sekondë për Qwen3-Coder 30B në mini PC dhe një Mac M4, dhe 16 tokenë në sekondë për një variant 40B REAP të Qwen3-Coder-Next. Një model 7B që arriti 43 tokenë në sekondë, sipas përshkrimit të TradeMAV, po funksiononte në 3060.
Modelet e dendura tregojnë një histori të ndryshme: një model 27B i dendur arriti 1.92 tokenë në sekondë në katër pajisje, dhe OpenAI’s gpt-oss-120b funksionoi në 1.37 tokenë në sekondë në një grup me gjashtë pajisje. Një model 120B në një konfigurim të ndryshëm me pesë pajisje arriti 3.1 tokenë në sekondë, pasi kaloi rreth shtatë minuta për të inicializuar. Kjo është më e mirë se një dështim për shkak të mungesës së memorie, e cila është propozimi i TradeMAV, por është jashtëzakonisht e ngadaltë.
Me pak fjalë, motori i RAMDeck rrethor softuer falas, specifikimet e hub-it janë të panjohura, dhe disa shifra të publikuara tregojnë kufizime kur përdoret ky qasje. Për ata që eksperimentojnë, mënyra RPC e llama.cpp dhe exo kushtojnë asgjë për t’u provuar. Për të gjithë të tjerët, 109 dollarët blejnë komoditet dhe, si me çdo hardware të financuar me crowdfunding, një premtim, jo një produkt.
Pasi nuk rekomandojmë ose mbështetim asnjë projekt crowdfunding. T gjitha kampanjat e crowdfunding-ut kanë rreziqe të ndërthurura, duke përfshirë mundësinë e vonesave, ndryshimeve ose mosdorëzimit të produkteve. Përdoruesit e mundshëm duhet të vlerësojnë me kujdes detajet dhe të veprojnë me vullnet.
Duke qenë se nuk është dhënë asnjë tekst burim, nuk mund të kryej një përkthim. Ju lutem, furnizoni tekstin që dëshironi të përkthehet.
Burimi: TechRadar.com